确定名字时用搜索框
已知作品名或作者名,直接搜索最快;不确定方向时,标签比关键词高效。
首页 / 功能详解
ao3 的检索不是靠一个搜索框撑起来的,真正决定结果好坏的是条件怎么叠、标签怎么读、阅读界面怎么调。这几件事各自独立,配合得好,找一篇想看的作品可以压到很短的时间内完成。
所有筛选条件之间都是"同时成立"的关系,每加一项就再砍掉一批结果。这决定了叠加顺序比条件本身更重要:先用原作圈把范围框到一个圈子,再用角色和配对锁人物关系,最后才用题材标签、字数和状态做收尾。反过来先加字数或状态,往往一上来就把结果砍到零,再回头找原因要花更多时间。
判断什么时候该停,看结果条数而不是看翻了几页。一般掉到几十条的量级,列表已经可以逐条浏览摘要去挑了;如果几十条里仍然没有想看的方向,说明缺的是一个标签条件而不是更多页数。这时候回退一步,把最严的那一项放宽,或者换一个更贴切的标签重新叠加。
作品页上的标签分几个维度同时呈现:内容分级、需要留意的情节提示、人物关系、登场角色以及题材方向。这些标签的作用不只是分类,它更像是打开正文之前的一份预告——先读标签,判断这个方向合不合口味,再决定要不要点进去,比直接看正文再退出省事得多。
标签的第二种读法是把它当成入口。任意一个标签都可以点开,进入该标签下的全部作品集合,再在这个集合里继续叠加其他条件。顺着标签一层层往下挖,往往能找到搜索框命中不了的作品,因为很多条目并不会把题材写进标题,只会打在标签上。分级和提示类标签建议养成"先看后读"的习惯,尤其是长篇,中途弃文的成本不低。
每个条件都提供两个方向:勾选"包含"会只保留符合该条件的条目,勾选"排除"则把符合该条件的条目直接移出列表。多数人只用包含,实际上排除往往更有效率——把明确不想碰的方向一次性排除掉,剩下的列表就都是能接受的范围,不用再逐条回避。
两者配合的常见做法是:用包含锁定两三个必须满足的条件(比如某个原作圈加某个配对),用排除清掉几个明确回避的题材或提示标签。这样组合下来结果精确,而且不依赖你事先想清楚"到底要看什么",只要知道自己"不看什么"就能筛出可读的列表。
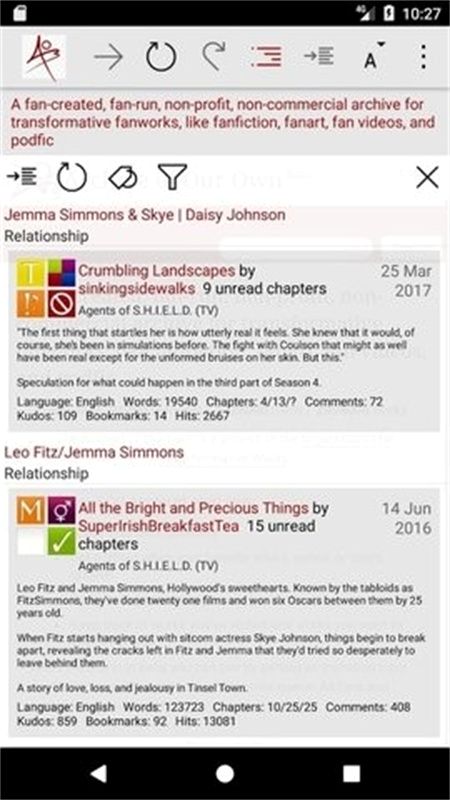
篇幅条件解决的是时间预算的问题。短篇适合通勤、午休这类碎片时段,一次读完不用记前面的情节;长篇和中长篇适合有整块时间的场景,代入感更完整,但需要留意章节总数和是否已完结。作品列表里通常会同时显示字数、章节进度和语言,用这几项配合自己的可用时间来做取舍,比按热度排序更贴合实际。
更新状态是另一个容易被忽略的维度。连载中的作品适合订阅跟进,能持续有新内容;已完结的作品适合一次读到底,不会遇到断更。如果只想找已经写完的长篇,把状态筛成"已完成"并设置一个字数下限,比在列表里逐个确认章节进度快得多。
已知作品名或作者名,直接搜索最快;不确定方向时,标签比关键词高效。
先给自己的可用时间定一个区间,再让列表去匹配,而不是反过来迁就列表。
阅读界面对长时间看文的影响比想象中大。字号偏小会让人不自觉地把手机拿近,背景纯白在夜里会明显刺眼。比较舒服的组合是:白天用浅色背景配中等字号,夜里切到深色背景并把字号调大一档,减少眼部负担。这类设置一般会在本地保存,调好一次之后不用每次重设。
加载方式上,长篇通常提供"整篇加载"和"按章加载"两种。整篇加载适合网络稳定、打算连续读完的场景,翻动更连贯;按章加载适合流量有限或者只是想先看看开头的场景,进入更快也更省流量。不确定要不要读下去的作品,建议先用按章的方式试读前一两章,确认之后再用整篇的方式继续。
作品可以保存到本地,在没有网络的时候继续阅读,这对通勤和出行场景很实用。需要注意的是离线保存会占用存储空间,长篇全本加上配图,体积并不小。比较合理的做法是只把确定要读的作品存下来,读完再清理,而不是把整份书签清单一次性全部下载。
下载前也值得确认一下作品的语言与篇幅,避免把不需要的内容一并存进手机。已经缓存过的条目在列表里通常会有标记,重复下载的情况可以据此避开。存到本地之后,如果没有登录账号,这部分内容只存在于当前设备,卸载应用时会一起被清掉。
检索条件决定了你会遇到哪些作品,书签与阅读记录决定你能不能找回来,离线缓存决定没有网络时还能不能继续读。这三段是连着的:前面挑得准,后面才存得少;存得少,离线时才管得过来。
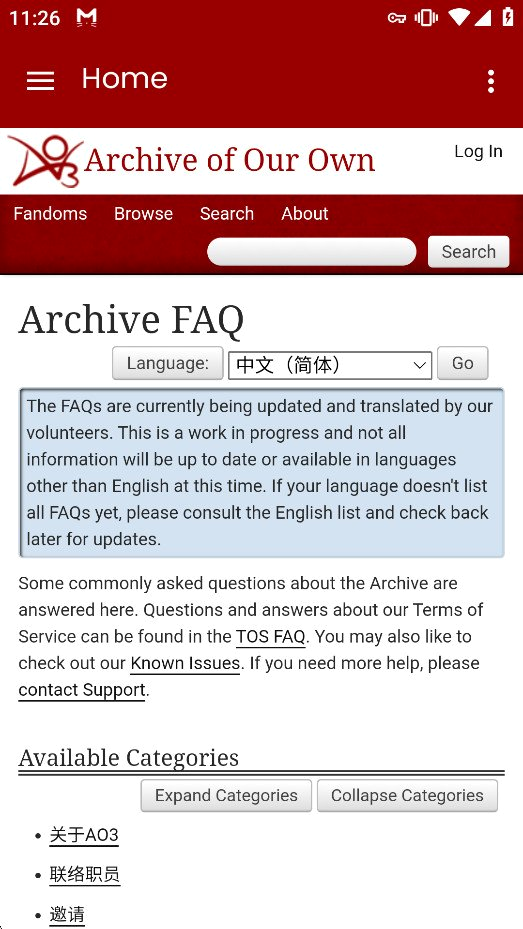
列表页的信息密度与帮助页的目录结构,直接决定了操作快慢
这些设置只有在自己手里调一遍才有感觉。挑一个熟悉的原作圈,从三层定位走到标签收尾,一轮下来就摸清了。